AI가 잊어야 할 것들,
‘머신 언러닝’이
필요한 이유
글. 신호철

AI가 이미 학습한 지식을 골라 지울 수 있을까. 개인정보나 저작물처럼 학습에서 제외해야 할 정보를 삭제하려는 ‘머신 언러닝’ 연구가 활발하다. 그러나 겉으로 답하지 않는 것과 실제로 기억하지 않는 것은 다르다. AI에 ‘망각’을 가르치는 연구와 한계를 살펴본다.
AI에도 ‘잊는 법’을 가르칠 수 있을까
영화 <이터널 선샤인>에는 잊고 싶은 기억을 지워주는 의료 회사가 나온다. 주인공 클레멘타인과 조엘은 헤어진 연인과의 아픈 기억을 잊기 위해 기억 제거 시술을 받는다. 특정한 사람에 관한 기억만 골라 없앤다는 설정이다. 과연 이런 기억 제거술이 현실에서 가능할까. 이 질문은 요즘 AI 연구에서도 떠오르고 있다. 모델이 이미 학습한 내용을 골라 지울 수 있느냐는 물음이다.
AI는 방대한 글을 읽으며 배운다. 학습 과정에서 비밀스러운 개인정보가 섞여 들어간 사실이 뒤늦게 발견될 수도 있다. 또 소설가가 자기 작품이 무단으로 학습된 사실을 알고 해당 내용을 지워달라고 요구한다면 어떻게 해야 할까. AI가 오래전 배운 내용을 골라 지울 수 있을까.
이 문제를 다루는 연구가 ‘머신 언러닝’이다. 학습을 뜻하는 러닝(Learning)에 반대의 뜻을 붙였다. 이미 배운 것을 취소한다는 의미다. 가장 분명한 방법은 문제가 된 자료를 빼고 모델을 처음부터 다시 학습시키는 것이다. 그러나 학습에 막대한 비용이 드는 거대한 AI를 매번 새로 학습시키기는 부담스럽다. 언러닝 연구자들은 훨씬 적은 비용으로 그에 가까운 결과를 얻으려 한다. 다른 능력은 남겨두면서 특정 자료의 영향만 덜어내야 한다.
2023년 마이크로소프트의 로넨 엘단과 마크 러시노비치는 ‘해리 포터가 누구죠?’라는 제목의 논문을 발표했다. 메타(Meta)의 언어 모델 라마2가 학습한 소설 <해리 포터>의 특정 내용을 잊게 하는 실험이었다. 등장인물과 줄거리를 훤히 아는 AI를, 그 소설을 읽지 않은 AI처럼 바꿀 수 있는지 보려 했다.
연구진은 AI가 소설과 무관한 답을 하도록 다시 가르쳤다. 가령 ‘해리 포터는 마법을 배운다’ 대신 ‘해리 포터는 과학을 배운다’라는 문장을 쓰게 하는 식이다. 해리 포터를 평범한 학생처럼 다루도록 반복해서 학습시켰다.
이 훈련을 거치자 AI의 답이 달라졌다. 해리 포터 이야기를 이어 쓰게 해도 작품을 모르는 듯한 답을 내놓았다. 언어 이해와 상식 등을 묻는 다른 시험의 성적은 대체로 유지됐다. 추가 학습에 든 계산량은 GPU 한 대를 약 한 시간 돌리는 수준이었다. 자료 준비와 평가 시간은 별도였다. 처음부터 새 모델을 만들지 않고도 특정 책을 잊게 할 수 있을 듯했다.
지운 기억은 왜 다시 나타날까
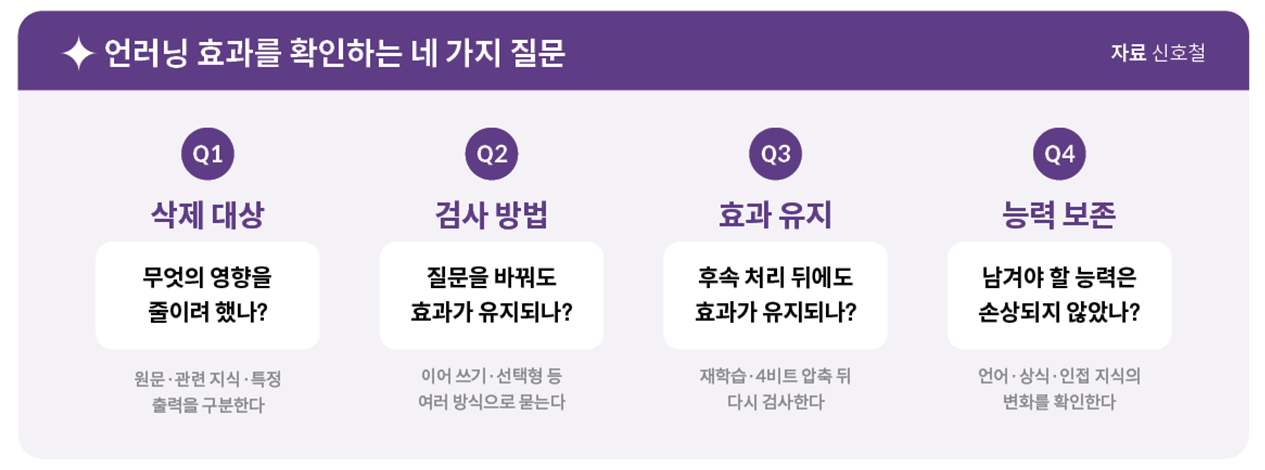
이듬해 다른 연구진이 같은 모델을 검사하자 남은 지식이 드러났다. 검사 방식이 달랐다. ‘해리 포터의 흰올빼미 이름은 무엇인가’ 같은 질문에 보기를 주고 A나 B를 고르게 했다. 연구진은 이런 퀴즈 1,239개를 만들었다. 성적은 언러닝 전 모델의 성적에 가까웠다. 즉, 소설에 관한 지식이 남아 있었다. 짧은 답을 쓰게 하는 검사에서는 오히려 원래 모델을 앞섰다.
보기에서 A나 B를 고를 때는 소설 속 이름을 직접 쓸 필요가 없다. 연구진은 이 점에 주목했다. 이름을 말하지 않도록 훈련했어도 정답을 고르는 능력은 남을 수 있다는 뜻이다. 답변에서 소설의 흔적을 없애는 것과 소설에 관한 지식을 없애는 것은 달랐다. 엘단과 러시노비치도 2023년 논문에서 더 집요하게 물으면 지식이 드러날 수 있다고 인정했다.
관련 글을 다시 학습시키자 원작 문장까지 돌아왔다. 2025년 국제학술대회 ICLR에 발표된 카네기멜런대 연구진의 실험이다. 이들은 라마2에 해리 포터의 일부 문단을 외우게 한 뒤 언러닝을 했다. 그다음 등장인물을 소개하는 글을 추가로 학습시켰다. 이 글에는 앞서 외운 원작 문구가 없었다. 그런데도 AI가 원작 문장을 다시 내놓는 사례가 나왔다. 연구진은 자신들이 시험한 방법이 기억을 충분히 지우지 못하고, 답이 나오는 것을 억제하는 데 그쳤다고 봤다.
언어 모델은 글을 읽으며 ‘가중치’라는 수많은 숫자를 바꾼다. 이 숫자들이 함께 작동해 다음 말을 정한다. 여러 책에서 배운 내용이 같은 숫자에 얽혀 있으니 해리 포터에 관한 지식만 골라 지우기 어렵다. 이미 학습에 쓰인 자료라면 원본 파일이나 대화 기록을 지워도 바뀐 숫자는 남는다. 기억의 끈은 복잡한 사슬로 얽혀 있다.
언러닝으로 답변이 달라졌다고 끝난 게 아니다. 모델을 작게 만드는 과정에서 잊게 하려고 가한 수정이 사라질 수 있다.
2025년 ICLR에 발표된 양자화 연구가 그 사례다. 양자화는 모델을 작게 만드는 기술이다. 가중치를 더 적은 비트로 표시해 저장 공간과 계산 부담을 줄인다. 가령 2.01과 2.02를 소수 둘째 자리에서 반올림하면 둘 다 2.0이 된다. 이처럼 가까운 수를 같은 값으로 처리하는 방식이다. 연구진이 언러닝을 마친 모델에 이런 압축 처리를 했다. 그러자 지우려던 정보가 다시 답변에 나타났다. 새 자료를 읽히지도 않았는데 삭제 효과가 약해졌다.
연구진은 반올림하면 언러닝 전후의 값이 같아질 수 있다고 설명했다. 잊게 하려고 가한 미세한 수정이 사라지는 것이다. 이 현상은 숫자의 정밀도를 크게 낮춘 4비트 양자화에서 뚜렷했다. 정밀도를 덜 낮춘 8비트에서는 삭제 효과가 대체로 유지됐다. 모든 압축에서 같은 결과가 나온 것은 아니다. ‘압축하니 거꾸로 기억이 늘었다’고 하면 오해다. 새로운 지식이 생긴 게 아니라 억눌렸던 정보가 다시 나온 것이다.
기억이 남아 있어도 꺼내지 못할 수 있다는 점은 뇌 연구에서도 확인된다. 2015년 연구진은 공포를 학습한 생쥐에게 단백질 합성을 억제하는 약물을 투여했다. 생쥐는 겁을 먹었던 장소에 가도 몸이 굳는 공포 반응을 잘 보이지 않았다. 하지만 학습 때 활성화됐던 신경세포를 빛으로 자극하자 몸이 굳는 반응이 돌아왔다. 기억의 흔적은 남아 있었던 것이다. 물론 포유류의 뇌가 AI와 똑같다는 뜻은 아니다. 다만 겉으로 나타나는 반응만으로 망각을 판단하기 어렵다는 점은 닮았다.
무엇을 지우고, 무엇을 남길 것인가
무엇을 지울지도 정해야 한다. 앞서 소개한 엘단과 러시노비치의 2023년 논문에서도 언러닝을 마친 모델은 가상의 학교를 나열하라는 요청을 받자 답변에 ‘호그와트’를 넣었다. 해리 포터에 나오는 마법학교다. 두 연구자는 백과사전 같은 소설 밖의 자료에서 배웠을 가능성을 들었다. 한 권의 책을 학습하지 않은 상태로 되돌리는 일과 그 책에 관한 모든 사실을 없애는 일은 목표가 다르다.
지울 대상을 정한 뒤에는 남길 능력을 지켜야 한다. 언러닝은 가중치를 다시 고치는 작업이다. 하지만 크게 바꾸면 남겨야 할 지식과 언어 능력까지 상할 수 있다. 마치 인간의 특정 기억을 없애겠다며 뇌를 손상시킬 수는 없듯 AI의 다른 능력까지 해쳐서는 안 된다.
실제로 앞서 퀴즈로 모델을 검사한 2024년 연구진은 다른 지식도 살펴봤다. 해리 포터를 잊게 한 모델의 답변에서는 영국 신화와 해리 포터 영화 제작에 관한 지식도 덜 드러났다. 소설 지식을 얼마나 지웠는지만 볼 일이 아니다. 남겨야 할 것을 얼마나 잃었는지도 살펴야 한다.
영화 <이터널 선샤인>이 개봉한 지 22년이 지났지만 인간의 기억을 골라 지우는 기술은 아직 나오지 않았다. AI도 마찬가지다. 잊기 어려운 이유도 인간의 뇌와 닮았을지 모른다. 인공지능이 기억하면 안 되는 내용은 처음부터 학습시키지 말아야 할 것 같다.
Profile. 신호철
- 서울대학교 연합전공 정치경제철학 초빙교수